쇼노트
새벽 3시, 갑자기 장애 알림이 울립니다. 급하게 노트북을 열어 대시보드를 확인하지만 CPU도 정상, 메모리도 정상, 에러율도 평소와 다르지 않습니다. 그런데 고객들은 결제가 안 된다며 불만을 쏟아냅니다. 도대체 어디서 문제가 발생한 걸까요?
이번 에피소드에서는 줄레 님이 최근 Datadog을 사용하면서 관심을 갖게 된 옵저버빌리티(Observability, 관측성)에 대해 이야기합니다. 단순히 시스템이 정상인지 감시하는 모니터링을 넘어, 예상하지 못한 장애가 발생했을 때 시스템 내부에서 무슨 일이 벌어지고 있는지 파악하려면 어떻게 해야 할까요?
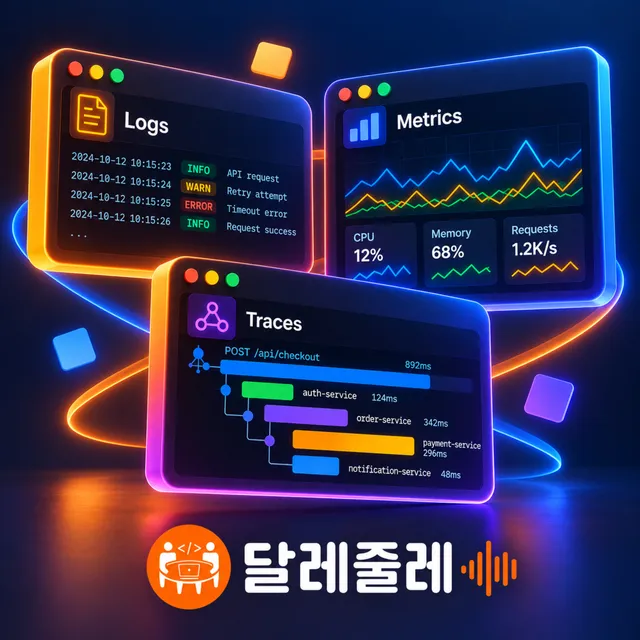
먼저 옵저버빌리티와 모니터링의 차이를 살펴보고, 관측성을 구성하는 세 가지 핵심 요소인 메트릭(Metrics), 트레이스(Traces), 로그(Logs)가 각각 어떤 역할을 하는지 알아봅니다. 이어서 관측성 데이터 수집의 개방형 표준인 OpenTelemetry(OTel)의 등장 배경과 구성 요소, 자동 계측과 수동 계측의 차이도 짚어봅니다.
이론에만 머무르지 않고 실제 장애 대응 과정도 살펴봅니다. 장바구니에 상품이 담기지 않는 상황을 예로 들어, 알림을 받고 지표를 확인한 다음 트레이스와 로그를 통해 원인을 좁혀가는 과정을 따라가 봅니다. Datadog, Grafana, Prometheus 같은 관측성 도구부터 PagerDuty를 활용한 온콜 대응, AI 시대에 중요해지는 LLM 옵저버빌리티까지 폭넓게 다룹니다.
달레 님의 경험담도 빠질 수 없습니다. 서버 24대에 터미널을 동시에 띄워 로그를 확인하던 시절부터, 디버그 로그를 너무 많이 남겨 디스크를 가득 채운 사고, 과도한 메트릭 수집으로 Datadog 요금을 폭증시킨 실수까지! 관측성을 확보하는 것도 중요하지만, 무엇을 얼마나 수집할지 판단하는 것 역시 개발자의 중요한 역할이라는 점을 생생한 경험을 통해 이야기합니다.
마지막으로 OpenTelemetry가 벤더 종속성을 줄이고 공통된 표준을 제공한다는 장점에도 불구하고, 실제 개발 현장에서는 여전히 벤더별 호환성과 레거시 시스템 때문에 어려움을 겪는 현실도 짚어봅니다.
서비스를 개발하는 것만큼이나 안정적으로 운영하는 일이 중요해진 요즘, 옵저버빌리티가 낯선 개발자부터 이미 관측성 도구를 사용하고 있지만 개념을 제대로 정리하고 싶은 개발자까지 함께 들어보시면 좋겠습니다.